Блок 1 — Python Basic (1–6)
- Лекция 1. Введение. Типизации. Переменные. Строки и числа. Булева алгебра. Ветвление
- Лекция 2. Обработка исключений. Списки, строки детальнее, срезы, циклы.
- Лекция 3. None. Range, list comprehension, sum, max, min, len, sorted, all, any. Работа с файлами
- Лекция 4. Хэш-таблицы. Set, frozenset. Dict. Tuple. Немного об импортах. Namedtuple, OrderedDict
- Лекция 5. Функции, типизация, lambda. Map, zip, filter.
- Лекция 6. Алгоритмы и структуры данных
Блок 2 — Git (7–8)
Блок 3 — Python Advanced (9–14)
- Лекция 9. Введение в ООП. Основные парадигмы ООП. Классы и объекты. Множественное наследование.
- Лекция 10. Magic methods. Итераторы и генераторы.
- Лекция 11. Imports. Standard library. PEP 8
- Лекция 12. Декораторы. Декораторы с параметрами. Декораторы классов (staticmethod, classmethod, property)
- Лекция 13. Тестирование
- Лекция 14. Проектирование. Паттерны. SOLID.
Блок 4 — SQL (15–17)
Блок 5 — Django (19–26)
- ▶ Лекция 19. Знакомство с Django
- Лекция 20. Templates. Static
- Лекция 21. Модели. Связи. Meta. Abstract, proxy.
- Лекция 22. Django ORM.
- Лекция 23. Forms, ModelForms. User, Authentication.
- Лекция 24. ClassBaseView
- Лекция 25. NoSQL. Куки, сессии, кеш
- Лекция 26. Логирование. Middleware. Signals. Messages. Manage commands
Блок 6 — Django Rest Framework (27–30)
Блок 7 — Python async (31–33)
Блок 8 — Deployment (34–35)
В рамках этого курса мы изучим то, как можно создавать сайты и приложения. Я надеюсь, ни для кого не окажется секретом, что любой сайт или приложение работают в сети интернет. Но как именно?
На самом деле большая часть работы — это результат выполнения различных запросов, и в первую очередь — запросов по
протоколу http (скорее, https, о чём мы поговорим значительно позже).
Когда вы набираете в браузере URL или просто переходите по закладкам или ссылкам, на самом деле вы заставляете браузер
создавать и отправлять GET HTTP-запрос. А когда вводите имя пользователя и пароль, чаще всего после кнопки, например,
«Войти», вы формируете и отправляете POST HTTP-запрос.
Чаще всего при работе с веб-ресурсами мы будем иметь дело с так называемым
взаимодействием запрос-ответ, что на английском звучит как request-response.
А это значит, что у нас есть кто-то, кто "спрашивает". И кто-то, кто "отвечает".
На самом деле спрашивать может любое устройство или приложение, которое способно
сформировать http запрос, а в современном мире это уже почти любое устройство, включая чайники, часы и стиральные
машины.
Но в самом распространённом варианте это всё-таки будут:
- Веб-браузеры (Chrome, Mozilla, Opera, их мобильные аналоги и т. п.)
- Приложения (Instagram, Telegram и т. п. Приложения бывают не только мобильные, но и для компьютера или планшета, и мы даже будем ими пользоваться в рамках курса)
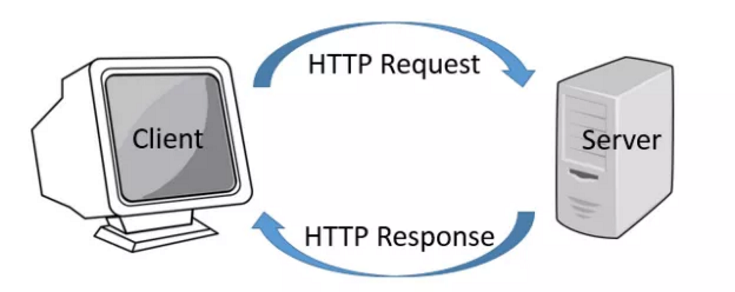
Отвечать может только сервер.
В отличие от задающего вопрос, отвечать может только специально подготовленный сервер. Сервером может являться любое электронное устройство, на котором можно запустить необходимый набор программ или команд. В рамках обучения вы будете запускать сервер прямо на ваших компьютерах, при разработке так обычно и делается, но реальные сайты и приложения обычно располагаются на специально подготовленных, изолированных или облачных компьютерах, и в случае веб-приложения на python это практически всегда будет компьютер с операционной системой Linux, зачем и как это настроить, мы поговорим ближе к концу нашего курса.

HTTP (HyperText Transfer Protocol) — это протокол передачи данных, который используется для общения между клиентом и сервером в интернете. Когда вы открываете сайт в браузере, браузер отправляет HTTP-запрос на сервер, а сервер отвечает HTTP-ответом.
Представьте HTTP как язык общения между вашим браузером и сервером. Как в обычном разговоре есть правила (поздороваться, задать вопрос, получить ответ), так и в HTTP есть чёткая структура общения.
Каждый HTTP-запрос состоит из нескольких частей:
-
Стартовая строка (Request Line) — содержит:
- Метод (GET, POST и т.д.) — что мы хотим сделать
- URL — куда мы обращаемся
- Версия протокола (HTTP/1.1, HTTP/2)
-
Заголовки (Headers) — служебная информация:
Host— адрес сервераUser-Agent— информация о браузереContent-Type— тип передаваемых данных- И многие другие
-
Тело запроса (Body) — данные, которые мы отправляем (не всегда присутствует)
Пример простого GET-запроса:
GET /articles/1/ HTTP/1.1
Host: example.com
User-Agent: Mozilla/5.0
Сервер отвечает похожей структурой:
-
Стартовая строка — содержит:
- Версия протокола
- Код статуса (200, 404, 500 и т.д.)
- Текстовое описание статуса
-
Заголовки — служебная информация ответа
-
Тело ответа — сами данные (HTML-страница, JSON, картинка и т.д.)
Пример ответа:
HTTP/1.1 200 OK
Content-Type: text/html

<html>...</html>
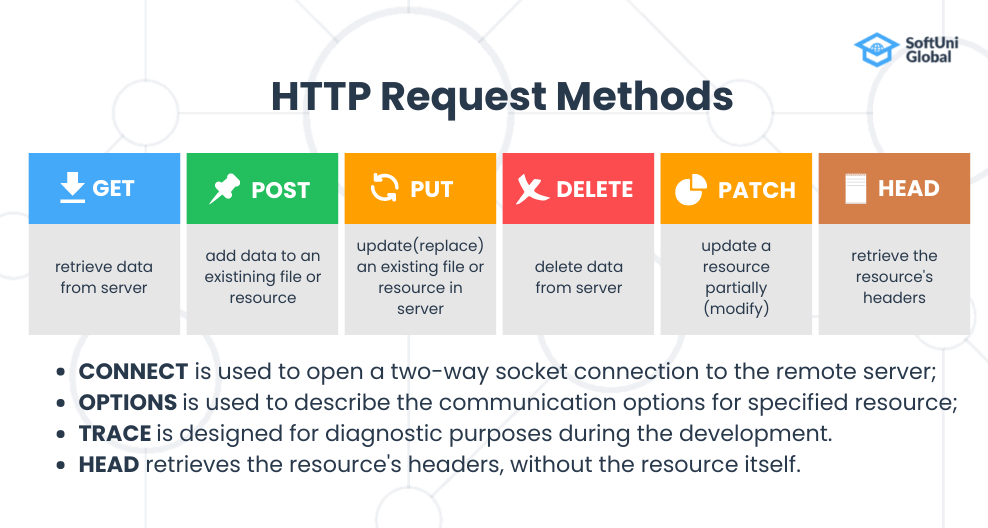
Метод HTTP определяет, какое действие мы хотим выполнить. Это ответ на вопрос "Как?" мы обращаемся к серверу.
Самый распространённый метод. Используется для получения информации с сервера.
Когда вы:
- Открываете любой сайт в браузере
- Смотрите список статей в блоге
- Читаете комментарии под постом
- Открываете видео на YouTube
...браузер отправляет GET-запрос.
GET-запрос может содержать query-параметры — дополнительные данные в URL после знака ?:
https://www.youtube.com/watch?v=dQw4w9WgXcQ&t=42s
Здесь v=dQw4w9WgXcQ и t=42s — это query-параметры. Они используются для уточнения запроса (фильтры, сортировка,
идентификаторы).
Важно: GET-запросы не должны изменять данные на сервере. Они только читают.
Используется для отправки данных на сервер и создания новых ресурсов.
Когда вы:
- Входите на сайт (логин/пароль)
- Оставляете комментарий
- Отправляете сообщение
- Оформляете заказ в интернет-магазине
- Загружаете файл
...браузер отправляет POST-запрос.
Данные передаются в теле запроса, а не в URL, поэтому POST безопаснее для передачи конфиденциальной информации.
- PUT — полная замена ресурса (отправляем все поля)
- PATCH — частичное обновление (отправляем только изменённые поля)
Примеры: изменить текст статьи, обновить профиль пользователя, изменить пароль.
Подробно будем разбираться с ними в следующем блоке курса.
Используется для удаления ресурсов: удалить комментарий, удалить статью, удалить аккаунт.
Подробно рассмотрим в следующем блоке.
Существуют и другие методы (HEAD, OPTIONS, TRACE), которые используются реже. О некоторых из них расскажу позже на практических примерах.

Мы разобрались с HTTP-методами — это ответ на вопрос "Как?" мы обращаемся к серверу. Но есть ещё один важный вопрос — "Куда?". На него отвечает URL.
URL (Uniform Resource Locator) — это унифицированный указатель ресурса, который используется для идентификации и доступа к ресурсам в Интернете. URL указывает на адрес ресурса и способ его получения. URL состоит из нескольких частей, каждая из которых имеет своё предназначение.
Вот основные компоненты URL:
-
Схема (Scheme):
- Определяет протокол, используемый для доступа к ресурсу. Наиболее распространённые схемы
включают
http,https,ftp,mailtoи другие. - Пример:
https
Мы будем практически до конца курса использовать только
http - Определяет протокол, используемый для доступа к ресурсу. Наиболее распространённые схемы
включают
-
Имя хоста (Hostname):
- Указывает на доменное имя или IP-адрес сервера, на котором размещен ресурс.
- Пример:
www.example.com
Мы будем использовать
127.0.0.1тоже практически до конца -
Порт (Port) (необязательный):
- Определяет порт, через который происходит соединение. Если порт не указан, используются порты по умолчанию для соответствующих схем (например, 80 для HTTP и 443 для HTTPS).
- Пример:
:443
Мы будем использовать
8000тоже практически до конца -
Путь (Path):
- Указывает на конкретный ресурс на сервере, такой как файл или страница.
- Пример:
/path/to/resource
Вот эта та часть, которую мы сегодня и научимся программировать
-
Запрос (Query) (необязательный):
- Содержит дополнительные параметры, передаваемые на сервер. Запрос начинается с символа
?, и параметры разделяются символами&. - Пример:
?key1=value1&key2=value2
- Содержит дополнительные параметры, передаваемые на сервер. Запрос начинается с символа
-
Фрагмент (Fragment) (необязательный):
- Указывает на часть ресурса, такую как якорь внутри страницы. Фрагмент начинается с символа
#. - Пример:
#section1
- Указывает на часть ресурса, такую как якорь внутри страницы. Фрагмент начинается с символа
https://www.example.com:443/path/to/resource?key1=value1&key2=value2#section1
URL используется во многих контекстах:
- Веб-браузеры используют URL для доступа к веб-страницам.
- API используют URL для отправки запросов к веб-сервисам.
- Программы и скрипты используют URL для загрузки файлов или доступа к удаленным ресурсам.
URL является важной частью Интернета, обеспечивая стандартизированный способ указания на ресурсы и взаимодействия с ними.
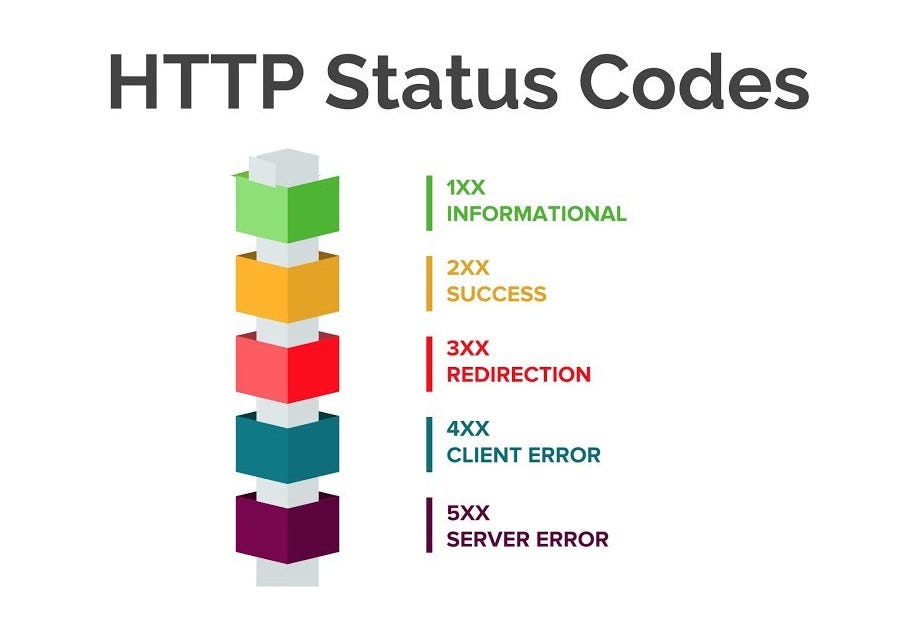
Когда сервер отвечает на запрос, он возвращает код статуса — число, которое говорит о результате обработки запроса.
-
1xx — Информационные
100 Continue— сервер получил начало запроса, клиент может продолжать101 Switching Protocols— сервер переключается на другой протокол (например, WebSocket)
-
2xx — Успех
200 OK— всё хорошо, запрос выполнен201 Created— ресурс успешно создан
-
3xx — Перенаправление
301 Moved Permanently— ресурс переехал навсегда302 Found— временное перенаправление
-
4xx — Ошибка клиента
400 Bad Request— неправильный запрос401 Unauthorized— требуется авторизация403 Forbidden— доступ запрещён404 Not Found— ресурс не найден
-
5xx — Ошибка сервера
500 Internal Server Error— ошибка на сервере503 Service Unavailable— сервер временно недоступен
Подробнее о структуре HTTP-сообщений можно почитать тут.
Таким образом, каждый HTTP-запрос и ответ можно описать тремя ключевыми элементами:
- Метод — что мы хотим сделать (GET, POST, PUT, DELETE)
- URL — куда мы обращаемся (адрес ресурса)
- Код статуса — что получилось (200, 404, 500 и т.д.)
Для разработки сложных решений используются шаблоны проектирования (patterns).
Если вы собираетесь строить дом, я сомневаюсь, что нужно придумывать собственный способ его постройки. Залить фундамент, на него поставить каркас, в каркасе провести коммуникации и сделать отделку.
Придумывание своих путей постройки дома, скорее всего, приведёт либо к неудовлетворительному результату, либо к невозможности достичь результата вообще.
Так вот, в программировании тоже все стандартные решения придумали за нас. Называются они паттерны, и вы уже слышали этот термин, когда обсуждали такие вещи как ООА\ООД\ООП.
В данный момент для нас с точки зрения создания веб-ресурсов самым важным из них является MVC (Model - View -
Controller) (Модель - Отображение - Контроллер)
Это архитектурный паттерн.
А по сути это разделение обязанностей между тремя зависимыми блоками.

Давайте посмотрим на работу обычного ресторана.
Клиент приходит, садится за столик и видит только меню и официанта. Выбрав что-то из меню, через официанта он отправляет запрос на кухню на приготовление его блюда. Официант в свою очередь идёт к поварам, чтобы сообщить о заказе, а повар, получив заказ, должен сначала понять, есть ли у него необходимые продукты и работает ли плита или духовка. В том случае, если всё хорошо, то повар готовит блюдо и после отдаёт его официанту, который и выносит блюдо клиенту.
Получается, что клиент видел только меню и конечное блюдо, но не видел повара или, тем более, склад с продуктами, но ожидаемый результат всё-таки получил.
Большая часть сайтов или приложений так же делится на три компонента, Model - View - Controller
Если рассматривать пример с рестораном, то зал, в котором находится клиент, его столик и его тарелка будут
являться Отображением, оно же View, В случае с сайтом или приложением, этим элементом является всё что может увидеть
пользователь.
Официант, который принимает заказ и выносит блюдо, является в этой аналогии http запросами и ответами. И общается
только с Контроллером, он же Controller
Кухня и повара на ней будут являться Контроллером, так как они могут принимать запросы от официантов, но при этом
могут сходить и на склад посмотреть, например, на наличие продуктов, а склад в нашем случае будет являться
моделью, Model. При написании веб-приложения, контроллером будет являться та часть кода, которая отвечает за обработку
запросов. И так же выполнять действия и с отображением, и с моделью.
Склад в этой конструкции будет являться моделью, Model, официант или клиент, не могут пойти на склад и взять себе
продуктов, это может сделать только повар, так же только повар может принять продукты у поставщика и добавить их на
склад. В случае с веб-приложениями моделью является абстракция над базой данных, и код, который отвечает за
взаимодействие с ней.
При этом клиент не может заказать всё, что ему захочется, ему нужно будет выбрать из меню.
Сегодня мы изучим, как именно формируется меню для Django, и что это вообще.
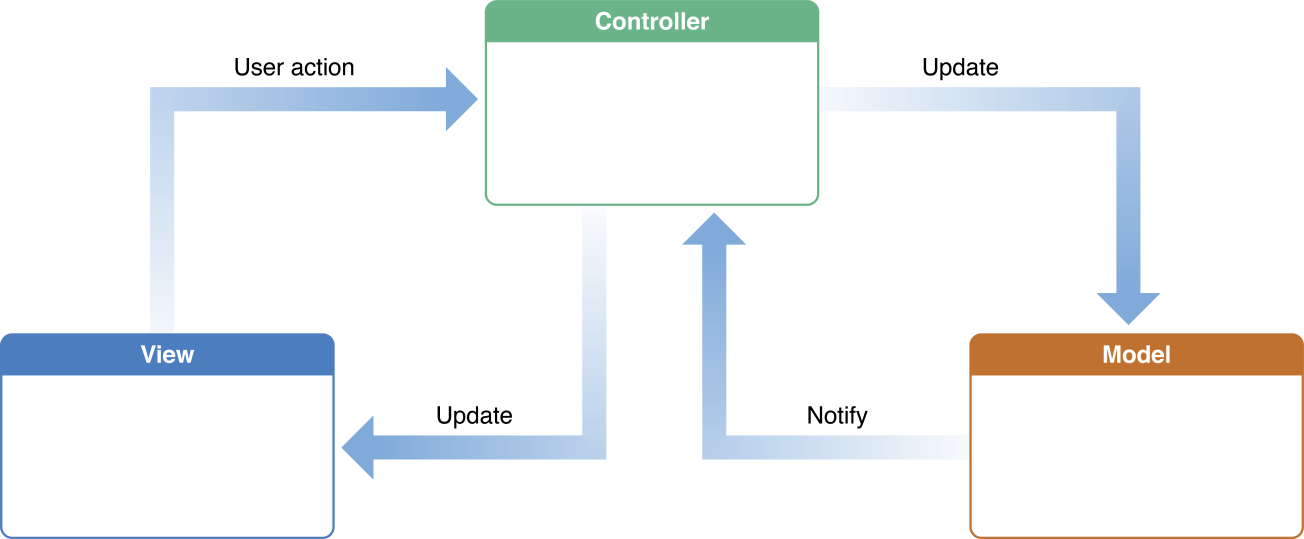
По этому же принципу работает и Django, но с немного другими названиями, паттерн
называется MVT (Model - View - Template)
Viewиграет рольControllerTemplateиграет рольView
Но это точно такая же идея, изменились только названия блоков.
Django — это веб-фреймворк, а фреймворк — это конструктор, который помогает нам собирать блоки, часто даже не задумываясь, как именно это работает под капотом.

Основной информационный ресурс Django
Всё, что мы делаем, мы делаем со свежим, только что созданным, активированным
ВИРТУАЛЬНЫМ ОКРУЖЕНИЕМ!!
Для создания проекта создаём виртуальное окружение и активируем его (описание в прошлой лекции).
После чего необходимо выполнить два действия:
- Установить Django
- Перейти в папку, где мы собираемся создать проект, в котором будем писать код.
Порядок этих двух действий не имеет значения, ведь установка пакета Django через pip установит пакет в папку
виртуального окружения, независимо от того, где вы находитесь.
Чтобы установить последнюю версию Django, необходимо выполнить команду:
python -m pip install djangoЕсли необходимо установить конкретную версию, нужно добавить ==x.y, например
python -m pip install django==x.yПосле установки django и перехода в папку, в которой вы собираетесь работать, необходимо создать проект, сделать это можно через такую команду:
django-admin startproject blog_projectИли создать проект в текущей директории, добавив точку в конце:
django-admin startproject blog_project .blog_project — это название вашего проекта, может быть таким, как вам необходимо. Мы будем создавать блог, поэтому
назовём проект соответствующе.
Эта команда создаёт новый проект и заполняет его базово нужными файлами. Давайте рассмотрим их.
Структура файлов:
blog_project/
    manage.py
    blog_project/
        __init__.py
        settings.py
        urls.py
        wsgi.py
        asgi.py
manage.py — файл, являющийся точкой входа, при помощи которого мы будем взаимодействовать со многими частями Django из консоли.
Внутри папки blog_project:
__init__.py — пустой файл, который говорит Python, что этот каталог должен рассматриваться как пакет Python.
settings.py — настройки и конфигурации проекта.
urls.py — URL-ы для этого проекта; «меню» вашего сайта на платформе Django.
wsgi.py — файл, отвечающий за входную точку сервера (позволяет запускать код как сайт), разберём почти в самом конце курса.
asgi.py — файл, отвечающий за входную точку сервера асинхронно (позволяет запускать код как сайт), разберём почти в самом конце курса.
Проверим работоспособность.
В консоли запустим локальный «сервер» из папки с нашим «сайтом» (в моём примере blog_project).
Если вы только что создали проект, то cd blog_project.
Необходимо находиться в консоли в той же папке, где находится
manage.pyс включённым виртуальным окружением.
python manage.py runserver
Что произойдёт в этой ситуации? Вы сообщили консоли, что хотите запустить python из виртуального окружения, через него
запустить файл manage.py с параметром runserver.
В консоли должна появиться примерно такая надпись.
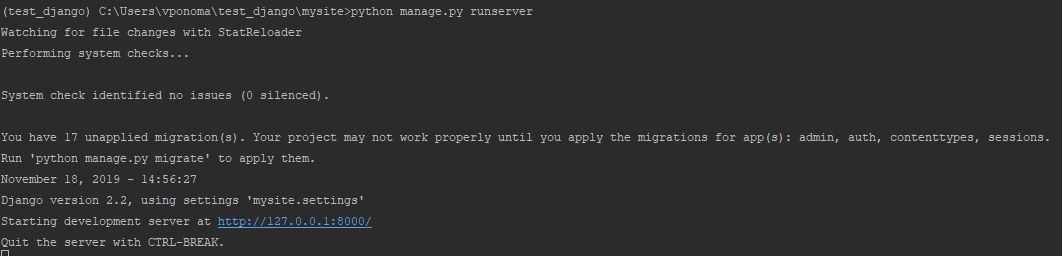
Эта команда запускает ваш
сервер. И если вы хотите, чтобы ваш сайт работал, сервер должен быть запущен!
Не закрывая консоль (сервер должен работать), открываем в браузере http://127.0.0.1:8000/
А браузер будет клиентом (помним о взаимодействии «клиент-сервер»?).
При таком подходе наш компьютер сразу является и клиентом (браузер), и сервером (скрипт запущенный в консоли).
127.0.0.1 — это локальный хост (обращаться к вашему же собственному компьютеру),
а :8000 — это номер порта, на котором запущен процесс (если не указывать порт, то по умолчанию будет использоваться 80
порт для http и 443 для https).
Когда вы открываете любой сайт, на самом деле, вы скрытым образом указываете порт. Для разработки часто используют те порты, на которых точно не будет ничего полезного (других программ работающих на вашем компьютере), для Django по умолчанию используется порт 8000, если нужно, его можно изменить.
localhost и 127.0.0.1 — эквивалентны (доступ с этого же компьютера). 0.0.0.0 — адрес привязки сервера; его используют при запуске: python manage.py runserver 0.0.0.0:8000. В браузере заходите по http://127.0.0.1:8000/ или по http://<IP_машины>:8000.
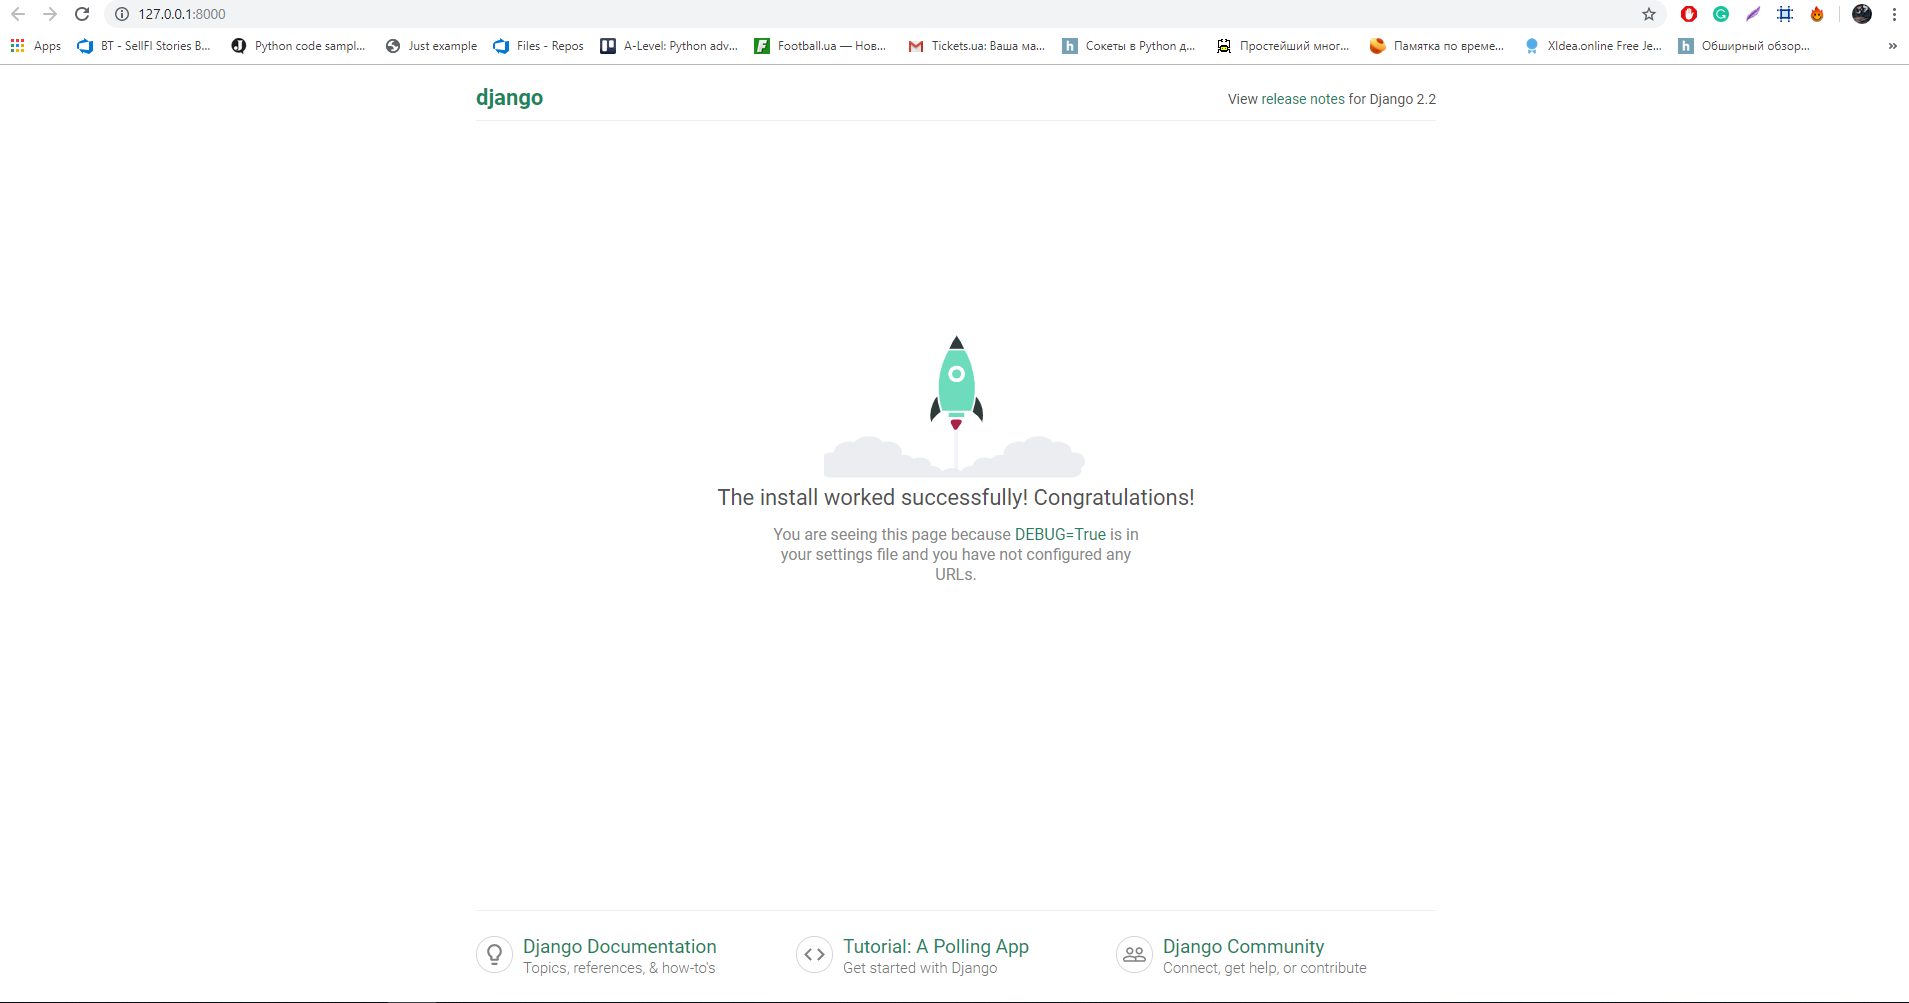
Если вы всё сделали правильно, то в браузере должны увидеть что-то такое:
Настройки и конфигурации — это замечательно, но разработка подразумевает использование отдельных модулей как части сайта (бывает один на весь сайт, а бывают и тысячи), такие модули называются приложениями, и именно в них пишется «суть» сайта.
Через консоль и уже известную нам manage.py создадим приложение для нашего блога:
python manage.py startapp blog
Команда создаст вам папку с вашим приложением. Давайте разберём её подробнее.
blog_project/
    manage.py
    blog_project/
        ...
    blog/
        __init__.py
        admin.py
        apps.py
        migrations/
            __init__.py
        models.py
        tests.py
        views.py
__init__.py — пустой файл, который говорит Python, что этот каталог должен рассматриваться как пакет Python.
admin.py — заготовка под страницу для администратора, удобный встроенный инструмент, разберём на следующих занятиях.
apps.py — информация о приложении, этот файл нам не мешает, как его можно использовать — тоже сильно дальше расскажу.
папка migrations — тут будут миграции базы данных.
models.py — модели.
tests.py — тесты.
views.py — контроллер приложения.
Все эти файлы нам пока не известны и, на самом деле, пока даже не нужны. Если вы удалите все, кроме
views.py, всё будет работать точно так же. Аviews.pyнам сегодня ещё понадобится.
После создания приложения его нужно добавить в настройки проекта:
# blog_project/settings.py
INSTALLED_APPS = [
    # ...
    "blog",
]
Теперь у нас всё готово для того, чтобы начать создавать наш сайт. Сегодня мы будем разбираться, как работают urls.
В рамках обучения мы будем запускать сервер через manage.py, и описание работы будет для него же. На самом деле, когда
запускаются сервера, они этот файл не используют, но логика полностью сохраняется.
Если вы откроете файл manage.py, то там вы увидите что-то такое:
#!/usr/bin/env python
"""Django's command-line utility for administrative tasks."""
import os
import sys


def main():
    """Run administrative tasks."""
    os.environ.setdefault("DJANGO_SETTINGS_MODULE", "blog_project.settings")
    try:
        from django.core.management import execute_from_command_line
    except ImportError as exc:
        raise ImportError(
            "Couldn't import Django. Are you sure it's installed and "
            "available on your PYTHONPATH environment variable? Did you "
            "forget to activate a virtual environment?"
        ) from exc
    execute_from_command_line(sys.argv)


if __name__ == "__main__":
    main()
Кстати обратите внимание и
__main__, использованиеsys,os. Все как мы учили.
Нас в данный момент интересует строчка:
os.environ.setdefault("DJANGO_SETTINGS_MODULE", "blog_project.settings")Она сообщает всей системе, что в качестве настроек нужно использовать файл settings.py из папки blog_project
Поэтому при любом запросе к запущенному Django приложению при обработке запроса запущенный сервер в первую очередь
заходит в файл settings.py и ищет там переменную ROOT_URLCONF, по умолчанию там будет указан файл urls.py, который
находится в той же папке, где и settings.py.
Внутри этого файла Django ожидает наличие переменной urlpatterns, которая содержит коллекцию (например, список),
состоящую из специальных объектов path или re_path.
На самом деле эти объекты появились в Django только после версии 2.0, сейчас актуальная версия — это 6+, но потенциально
вы можете встретить и версии ниже, например, 1.11, поэтому ниже мы разберём и более старые варианты урлов. До 2.0 там
были коллекции из объектов url, и все они работали на регулярных выражениях, о них позже.
Вся основная логика обработки запросов пишется в приложениях в файлах views.py, у нас всего одно приложение, поэтому
всю логику (сегодня она будет простейшая) мы будем писать в файл blog/views.py.
Давайте начнём с самого простого — функция, которая возвращает текст «Hello, World!»:
# blog/views.py
from django.http import HttpResponse


def hello(request):
    return HttpResponse("Hello, World!")
Мы создали функцию, которая принимает один параметр request и возвращает объект типа HttpResponse.
Это нужно, потому что вся веб-инфраструктура работает на request-response системе, мы тоже не будем её нарушать, и
будем принимать запросы и возвращать ответы.
Объект HttpResponse мы импортировали из Django, и на данном этапе нас совершенно не интересует, как он работает, как и
то, что именно находится в переменной request.
По сути, эта функция является контроллером, но не спешите, контроллеры мы будем подробно изучать дальше.
Для использования этого контроллера в качестве логики, он должен быть описан в файле urls.py:
# blog_project/urls.py
from django.urls import path
from blog.views import hello

urlpatterns = [
    path('hello/', hello),
]
Мы импортировали path из Django и функцию hello из нашего views.py
Объект path принимает два обязательных параметра:
- Строка, которая содержит
путь - Обработчик, что именно должно происходить при запросе по такому пути.
Строка, которая указывает, как именно можно выполнить запрос к данному url.
Например, если указать там hello/ и запустить сервер на локалхосте на 8000 порту, то запросы нужно выполнять по
адресу 127.0.0.1:8000/hello/
Если указать пустую строку '', то это будет главная страница: 127.0.0.1:8000/
Не может содержать пробелов, может содержать /
Что угодно, что можно вызвать (), на данном этапе это функции, дальше мы будем использовать классы. При вызове
добавляем в качестве аргумента переменную request.
Объект path так же может принимать атрибут name=, который нужен для автоматической генерации адресов, будем изучать
на следующем занятии, и некоторые другие необязательные атрибуты.
Если мы перезапустим (ну или запустим) сервер и откроем страницу, то мы увидим текст «Hello, World!».
Список урлов проекта называется routing (маршрутизация). Маршрутизацию можно строить так, как вам удобно, или как того
требует задание.
Теперь создадим что-то более осмысленное — главную страницу и страницу «О блоге»:
# blog/views.py
from django.http import HttpResponse


def hello(request):
    return HttpResponse("Hello, World!")


def home(request):
    return HttpResponse("Добро пожаловать в наш блог!")


def about(request):
    return HttpResponse("Это блог о программировании на Python и Django")
А в файле blog_project/urls.py импортируем эти функции и добавим маршруты:
# blog_project/urls.py
from django.urls import path
from blog.views import hello, home, about

urlpatterns = [
    path('', home, name='home'),
    path('hello/', hello, name='hello'),
    path('about/', about, name='about'),
]
Теперь у нас есть три страницы:
http://127.0.0.1:8000/— главная страница блогаhttp://127.0.0.1:8000/hello/— наш первый тестовый URLhttp://127.0.0.1:8000/about/— страница «О блоге»
URL может принимать параметры — динамические части адреса. Это очень важно для блога: нам нужно показывать разные статьи по разным адресам.
Синтаксис параметра: <тип:имя_переменной>
# blog/views.py
def article_detail(request, pk):
    return HttpResponse(f"Статья #{pk}")
# blog_project/urls.py
from django.urls import path
from blog.views import home, about, article_detail
urlpatterns = [
path('', home, name='home'),
path('about/', about, name='about'),
path('articles/<int:pk>/', article_detail, name='article-detail'),
]Теперь при переходе на http://127.0.0.1:8000/articles/1/ мы увидим «Статья #1», а на http://127.0.0.1:8000/articles/42/ — «Статья #42».
Всего существует 5 встроенных типов:
-
str — непустая строка без символа
/. Используется по умолчанию. -
int — ноль или любое положительное целое число.
-
slug — строка из букв, цифр, дефисов и подчёркиваний. Например:
my-first-article,python-django-tutorial. Идеально подходит для человекочитаемых URL статей. -
uuid — UUID в формате
075194d3-6885-417e-a8a8-6c931e272f00. -
path — строка, которая может содержать
/.
Добавим URL для списка статей и просмотра статьи по slug:
# blog/views.py
from django.http import HttpResponse


def home(request):
    return HttpResponse("Добро пожаловать в наш блог!")


def about(request):
    return HttpResponse("Это блог о программировании на Python и Django")


def article_list(request):
    return HttpResponse("Список всех статей")


def article_detail(request, pk):
    return HttpResponse(f"Статья #{pk}")


def article_by_slug(request, slug):
    return HttpResponse(f"Статья: {slug}")
# blog_project/urls.py
from django.urls import path
from blog.views import home, about, article_list, article_detail, article_by_slug
urlpatterns = [
path('', home, name='home'),
path('about/', about, name='about'),
path('articles/', article_list, name='article-list'),
path('articles/<int:pk>/', article_detail, name='article-detail'),
path('articles/<slug:slug>/', article_by_slug, name='article-by-slug'),
]Примеры URL:
http://127.0.0.1:8000/articles/— список статейhttp://127.0.0.1:8000/articles/1/— статья с id=1http://127.0.0.1:8000/articles/my-first-post/— статья со slug «my-first-post»
Важно: URL проверяются сверху вниз. Если URL подходит под несколько паттернов, будет использован первый подходящий. Поэтому более специфичные URL должны быть выше.
На самом деле path может принимать не только обработчик, но и специальный параметр include, который позволяет
добавить urls из другого файла к основному.
Например, все URL, связанные со статьями, начинаются на articles/. Удобно вынести их в отдельный файл внутри
приложения blog. Это стандартная практика в Django.
Создадим файл blog/urls.py:
# blog/urls.py
from django.urls import path
from blog.views import article_list, article_detail, article_by_slug

urlpatterns = [
    path('', article_list, name='article-list'),
    path('<int:pk>/', article_detail, name='article-detail'),
    path('<slug:slug>/', article_by_slug, name='article-by-slug'),
]
Теперь изменим главный файл blog_project/urls.py:
# blog_project/urls.py
from django.urls import path, include
from blog.views import home, about

urlpatterns = [
    path('', home, name='home'),
    path('about/', about, name='about'),
    path('articles/', include('blog.urls')),
]
После этого изменения ни один URL не изменился — они просто стали по-другому располагаться в коде.
Когда у вас 20 приложений и тысячи URL, такая структура становится критически важной. Правило хорошего тона в Django — создавать файл
urls.pyв каждом приложении, а в основном файле хранить только командыinclude.

Как говорит нам википедия Регуля́рные выраже́ния (англ. regular expressions) — это формальный язык поиска и манипуляций с подстроками в тексте, основанный на использовании метасимволов.
По факту это механизм, который позволяет понять, соответствует ли наша строка заданному шаблону.
Иногда стандартных типов параметров (int, str, slug) недостаточно. Например, нам нужен URL с датой в формате
YYYY-MM-DD. Для таких случаев используется re_path.
Допустим, мы хотим показывать статьи за определённую дату. URL должен выглядеть так:
/articles/2024-01-15/ — статьи за 15 января 2024 года.
Для проверки регулярных выражений рекомендую regex101.com.
# blog/views.py
from django.http import HttpResponse


def home(request):
    return HttpResponse("Добро пожаловать в наш блог!")


def about(request):
    return HttpResponse("Это блог о программировании на Python и Django")


def article_list(request):
    return HttpResponse("Список всех статей")


def article_detail(request, pk):
    return HttpResponse(f"Статья #{pk}")


def articles_by_date(request, year, month, day):
    return HttpResponse(f"Статьи за {day}.{month}.{year}")
# blog_project/urls.py
from django.urls import path, include, re_path
from blog.views import home, about, articles_by_date
urlpatterns = [
path('', home, name='home'),
path('about/', about, name='about'),
path('articles/', include('blog.urls')),
re_path(
r'^articles/(?P<year>\d{4})-(?P<month>\d{2})-(?P<day>\d{2})/$',
articles_by_date,
name='articles-by-date'
),
]Разберём регулярное выражение:
^articles/— URL начинается с "articles/"(?P<year>\d{4})— именованная группаyear, ровно 4 цифры-— дефис-разделитель(?P<month>\d{2})— именованная группаmonth, ровно 2 цифры-— дефис-разделитель(?P<day>\d{2})— именованная группаday, ровно 2 цифры/$— URL заканчивается слешем
Теперь при переходе на http://127.0.0.1:8000/articles/2024-01-15/ мы увидим «Статьи за 15.01.2024».
Важно: Все параметры из
re_pathприходят как строки. Если нужны числа, конвертируйте их в контроллере:year = int(year).
Бывают и более сложные конструкции, рассмотрите их по вот этой ссылке
На практике re_path используется редко — обычно хватает стандартных типов параметров в path.
Как сдавать домашку?
Тут ссылка с подробностями.
← Лекция 18: Virtual env. Pip. Устанавливаемые модули. Pyenv. | Лекция 20: Templates. Static →