Блок 1 — Python Basic (1–6)
- Лекция 1. Введение. Типизации. Переменные. Строки и числа. Булева алгебра. Ветвление
- Лекция 2. Обработка исключений. Списки, строки детальнее, срезы, циклы.
- Лекция 3: None. Range, list comprehension, sum, max, min, len, sorted, all, any. Работа с файлами
- Лекция 4. Хэш таблицы. Set, frozenset. Dict. Tuple. Немного об импортах. Namedtuple, OrderedDict
- Лекция 5. Функции, типизация, lambda. Map, zip, filter.
- ▶ Лекция 6. Алгоритмы и структуры данных
Блок 2 — Git (7–8)
Блок 3 — Python Advanced (9–14)
- Лекция 9. Введение в ООП. Основные парадигмы ООП. Классы и объекты. Множественное наследование.
- Лекция 10. Magic methods. Итераторы и генераторы.
- Лекция 11. Imports. Standard library. PEP8
- Лекция 12. Декораторы. Декораторы с параметрами. Декораторы классов (staticmethod, classmethod, property)
- Лекция 13. Тестирование
- Лекция 14. Проектирование. Паттерны. SOLID.
Блок 4 — SQL (15–17)
Блок 5 — Django (19–26)
- Лекция 19. Знакомство с Django
- Лекция 20. Templates. Static
- Лекция 21. Модели. Связи. Meta. Abstract, proxy.
- Лекция 22. Django ORM.
- Лекция 23. Forms, ModelForms. User, Authentication.
- Лекция 24. ClassBaseView
- Лекция 25. NoSQL. Куки, сессии, кеш
- Лекция 26. Логирование. Middleware. Signals. Messages. Manage commands
Блок 6 — Django Rest Framework (27–30)
Блок 7 — Python async (31–33)
Блок 8 — Deployment (34–35)

Алгоритмы лежат в основе программирования и помогают решать задачи эффективно по времени и памяти. Они применяются повсюду: от простой обработки данных до сложных систем.
- Эффективное решение проблем — быстрее и с меньшими ресурсами.
- Оптимизация программ — правильный выбор алгоритма ускоряет код.
- Понимание сложных систем — легче разбираться в устройстве ПО.
- Универсальность — применимы в анализе данных, ML, играх и многом другом.
О большое (Big O notation) — это математическое обозначение, используемое для описания эффективности алгоритма, особенно его временной и пространственной сложности. Оно позволяет оценить, как изменяется время выполнения или объем используемой памяти по мере роста размера входных данных.
- O(1) — Постоянное время: Время выполнения не зависит от размера входных данных.
- O(log n) — Логарифмическое время: Время выполнения растёт логарифмически по мере увеличения входных данных.
- O(n) — Линейное время: Время выполнения растёт линейно по мере увеличения входных данных.

График выше иллюстрирует, как быстро растёт время/память в зависимости от класса сложности. Он важен для интуиции, но помните: Big‑O — это оценка порядка роста, а не точное время.
- O(n log n) — Линейно-логарифмическое время: Время выполнения растёт быстрее, чем линейно, но медленнее, чем квадратично.
- O(n^2) — Квадратичное время: Время выполнения растёт квадратично по мере увеличения входных данных.
- O(2^n) — Экспоненциальное время: Время выполнения растёт экспоненциально по мере увеличения входных данных.
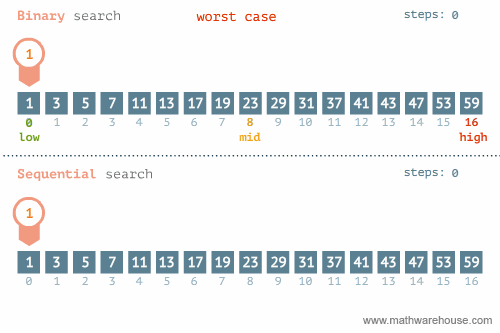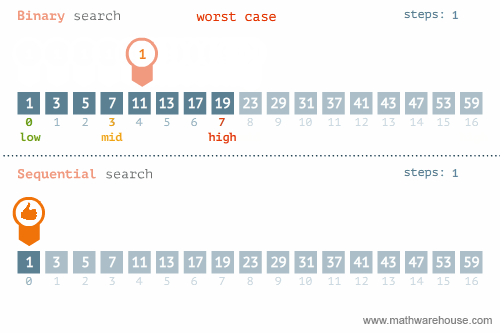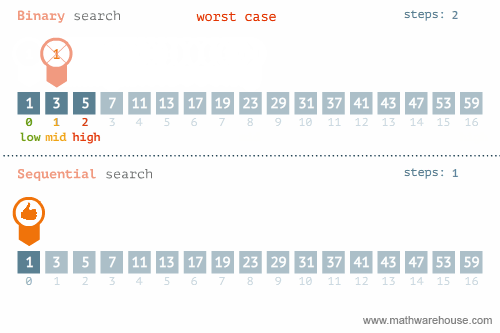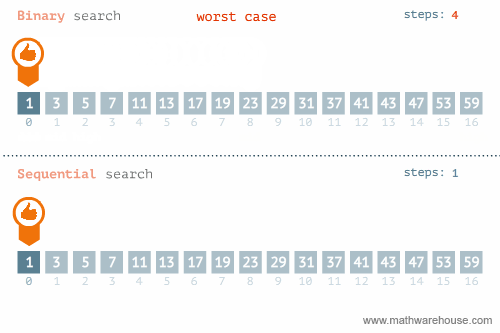
Для понимания того, что такое сложность, давайте рассмотрим один из базовых алгоритмов — бинарный поиск.
Предположим, нам нужно угадать, какое число загадал пользователь в диапазоне от 1 до 100. Пользователь говорит нам: его число больше, меньше или мы угадали.
У нас есть несколько стратегий для решения этой задачи. Первая — это решение «в лоб». Мы просто перебираем все варианты от 1 до 100. Но при этом в худшем случае мы выполним 100 запросов. А что если диапазон будет до 1000? А до 10 000 000?
При таком подходе у нас увеличивается количество действий, которые нужно сделать, вместе с количеством данных, для которых мы это выполняем. Такие алгоритмы имеют сложность O(n). Увеличение объёма данных увеличивает сложность ровно во столько же раз, как и увеличился объём данных.
А можно ли выполнить этот же поиск за меньшее количество действий? Можно! Для этого нам поможет бинарный поиск.
Мы можем разделить весь наш интервал пополам и начать поиск с 50. Узнать, что искомый элемент больше. Тогда мы берём середину от оставшихся значений (от 50 до 100) и проверяем 75. И делаем так до тех пор, пока не найдём искомое значение.
Такие алгоритмы имеют сложность O(log n). Для диапазона от 1 до 100, нам понадобится в худшем случае (log 100 ==
6,644) 7 попыток.
Лучше, чем 100, правда? А для диапазона от 1 до 1000 (log 1000 == 9,966) всего 10 попыток! Мы увеличили входные данные в
10 раз, а сложность вычисления увеличилась всего в полтора раза!
Для очень большого количества задач уже существуют оптимальные алгоритмы — если их знать и уметь использовать, ваш код будет гораздо эффективнее.
Давайте посмотрим, как это можно реализовать:
Бинарный поиск — это алгоритм для поиска элемента в отсортированном списке. Он работает по принципу «разделяй и властвуй», разделяя массив на половины до тех пор, пока не найдёт искомый элемент.
- Найдите средний элемент списка.
- Если средний элемент равен искомому, верните его индекс.
- Если искомый элемент меньше среднего, повторите поиск для левой половины списка.
- Если искомый элемент больше среднего, повторите поиск для правой половины списка.
- Продолжайте до тех пор, пока не найдёте элемент или не исчерпаете список.
def binary_search(arr: list[int], target: int) -> int:
    left, right = 0, len(arr) - 1

    while left <= right:
        mid = (left + right) // 2
        if arr[mid] == target:
            return mid
        elif arr[mid] < target:
            left = mid + 1
        else:
            right = mid - 1

    return -1  # Элемент не найден


# Пример использования
arr = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
target = 7
print(f"Элемент найден на индексе: {binary_search(arr, target)}")
Рекурсия — это концепция в программировании, при которой функция вызывает саму себя внутри своего тела. Это мощный инструмент, который позволяет решать задачи, которые могут быть разбиты на более мелкие подзадачи того же типа. Рекурсия в Python работает аналогично рекурсии в математике.
-
Базовый случай (Base Case): Это условие, при котором рекурсия завершается и функция больше не вызывает саму себя. Без базового случая рекурсивная функция будет вызывать себя бесконечно.
-
Рекурсивный случай (Recursive Case): Это условие, при котором функция вызывает саму себя для решения более мелкой подзадачи. Рекурсивный случай должен быть сформулирован так, чтобы в конечном итоге привести к базовому случаю.
Давайте рассмотрим пример рекурсивной функции для вычисления факториала числа. Факториал числа n (обозначается как n!) — это произведение всех положительных целых чисел от 1 до n.
def factorial(n: int) -> int:
    # Валидация: факториал определён для n >= 0
    if n < 0:
        raise ValueError("n must be >= 0")
    # Базовый случай: 0! и 1! равны 1
    if n < 2:
        return 1
    # Рекурсивный случай
    return n * factorial(n - 1)


# Пример использования
result = factorial(5)
print(result)  # 120
Примечание: в Python глубина рекурсии ограничена (RecursionError при слишком глубокой рекурсии), а оптимизация хвостовой рекурсии не применяется. Для простых задач чаще предпочтительны итеративные решения.
Преимущества:
- Рекурсия может сделать код более читаемым и интуитивно понятным, особенно для задач, связанных с древовидными или рекурсивными структурами данных.
- Она может предоставить более лаконичное и элегантное решение для некоторых задач.
Ограничения:
- Рекурсия может быть менее эффективной по сравнению с итеративными методами в некоторых случаях из-за накладных расходов на вызов функций.
- Слишком глубокая рекурсия может вызвать переполнение стека вызовов (stack overflow), что приведёт к ошибке.
При использовании рекурсии важно правильно формулировать базовый и рекурсивный случаи, чтобы функция завершилась и не вошла в бесконечный цикл.
Пример бинарного поиска через рекурсию:
def binary_search_recursive(arr: list[int], target: int, left: int, right: int) -> int:
    if left > right:
        return -1  # Элемент не найден

    mid = (left + right) // 2

    if arr[mid] == target:
        return mid
    elif arr[mid] < target:
        return binary_search_recursive(arr, target, mid + 1, right)
    else:
        return binary_search_recursive(arr, target, left, mid - 1)


# Пример использования
arr = [1, 2, 3, 4, 5, 6, 7, 8, 9, 10]
target = 7
result = binary_search_recursive(arr, target, 0, len(arr) - 1)

print(f"Элемент найден на индексе: {result}")Иногда удобнее не реализовывать бинарный поиск вручную, а использовать стандартный модуль bisect.
Он помогает быстро находить позицию вставки элемента в отсортированный список:
from bisect import bisect_left, bisect_right

arr = [1, 3, 3, 5]
i = bisect_left(arr, 3)  # 1 — индекс первого вхождения 3
j = bisect_right(arr, 3)  # 3 — индекс после последнего вхождения 3
# Вставка с сохранением порядка:
arr.insert(i, 3)
Важно: бинарный поиск корректен, только если массив уже отсортирован.
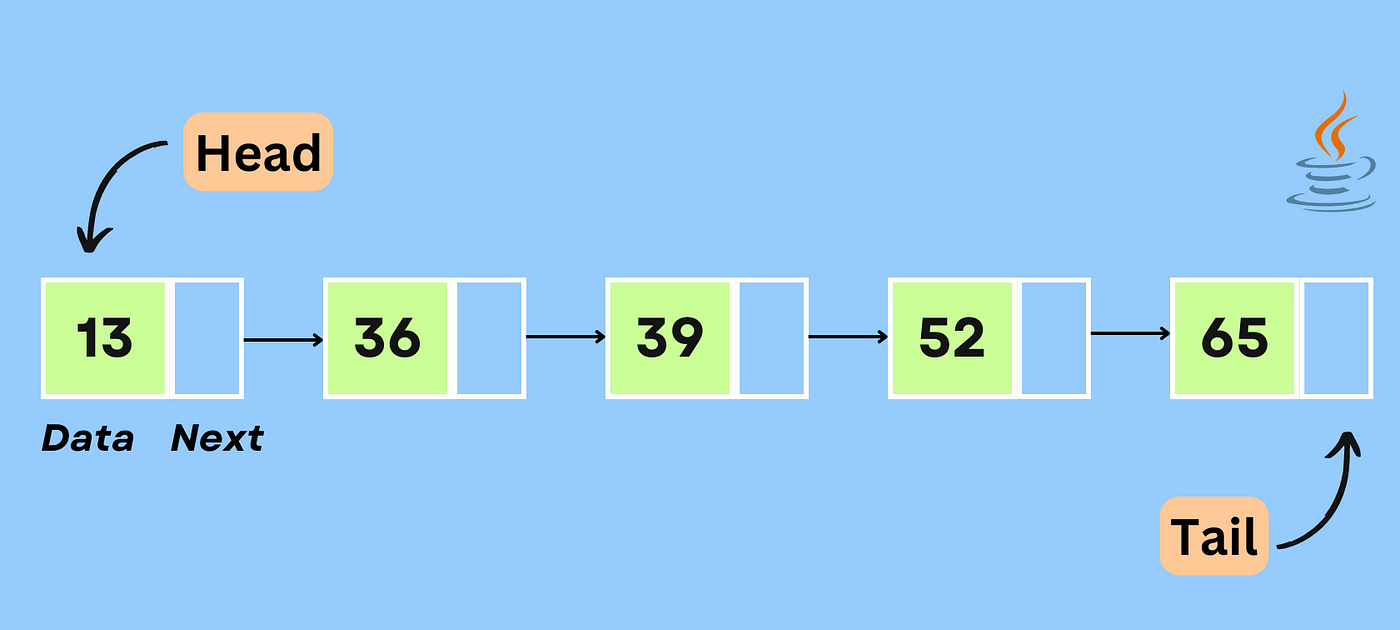
- Связный список — это последовательность узлов, каждый хранит значение и ссылку на следующий узел (в двусвязном — ещё и на предыдущий).
- Виды: односвязный, двусвязный, циклический.
- Вставка в голову: O(1)
- Удаление «после данного узла»: O(1)
- Вставка/удаление в хвост: O(1), если есть указатель на хвост (иначе O(n))
- Поиск по значению, доступ по индексу: O(n) — случайного доступа нет
- Разворот списка (reverse): O(n) по времени и O(1) по памяти при итеративной реализации (меняем ссылки)
- Память: есть накладные расходы на ссылки; локальность данных хуже, чем у массивов
list— динамический массив: доступ по индексу O(1); добавление/удаление в конец амортизированно O(1); вставки/удаления в середине — O(n)- Связный список — наоборот: «дешёвы» локальные вставки/удаления (при наличии ссылки на предшественника), но поиск/индексирование — O(n)
- В Python на практике чаще используют
listиcollections.deque; связные списки полезны как концепция и в задачах системного уровня
- Хеш‑таблицы: метод цепочек (chaining) для разрешения коллизий (без них словари не знали бы порядок ключей, но с Python 3.7 они сохраняют порядок вставки)
- Двусвязные списки в LRU‑кэше, в ядре ОС, в движках БД
- Вспомогательные структуры в компиляторах/интерпретаторах, пайплайнах обработки
node = ("A", ("B", ("C", None))) # (value, next)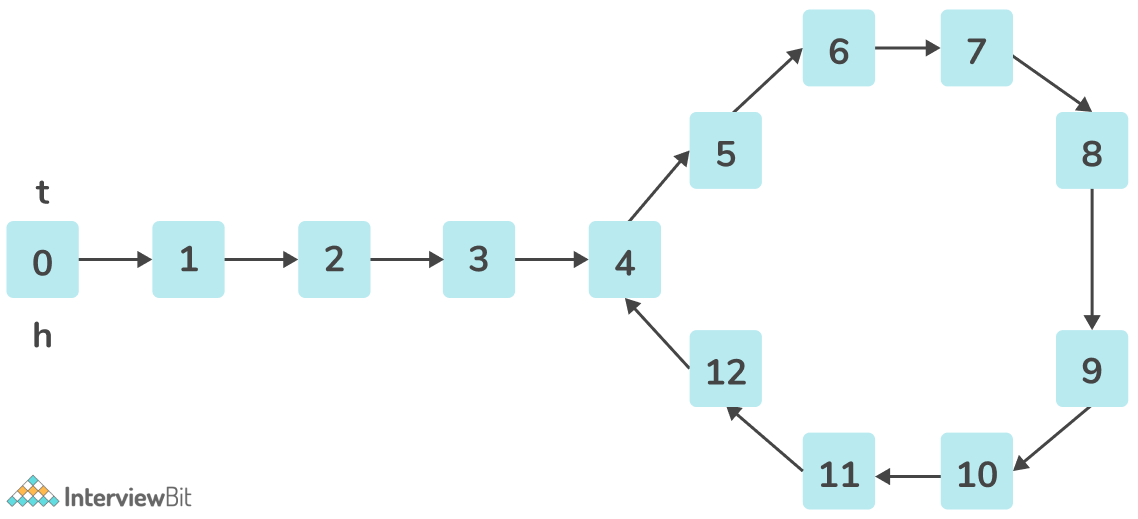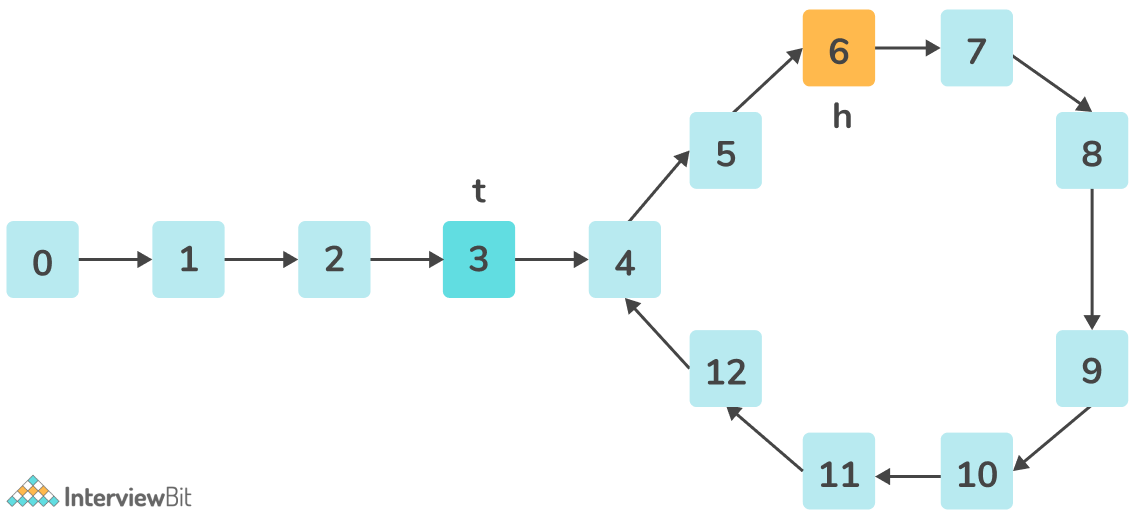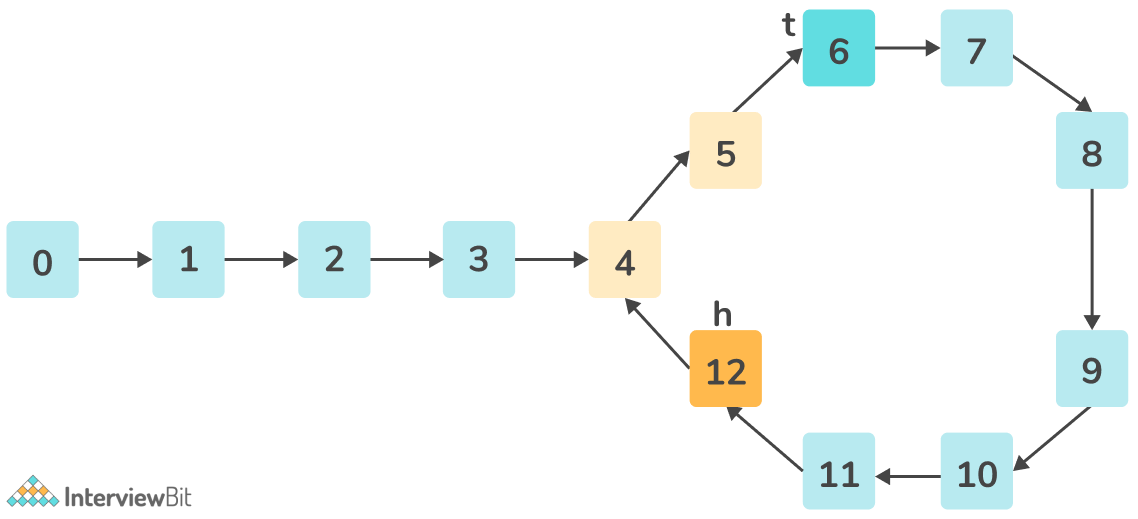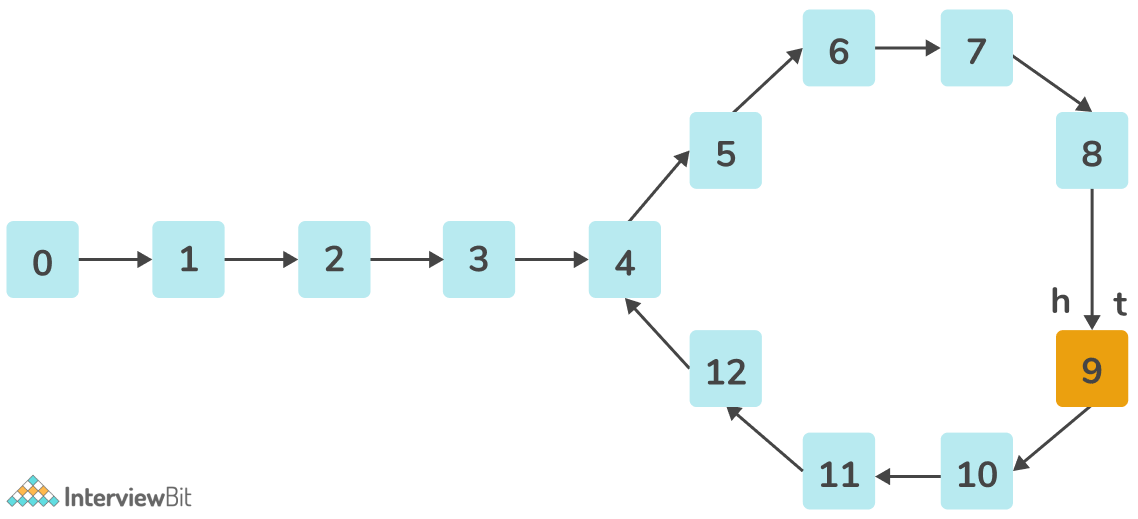
Циклический связный список не имеет «хвоста», указывающего на None: последний узел ссылается на один из предыдущих (часто — на голову), образуя цикл.
- Где применяют: круговые очереди и буферы, планирование по циклу (round‑robin), итерация «по кольцу», сторожевой (sentinel) узел для упрощения граничных случаев.
- Особенности: при обходе легко зациклиться — нужен счётчик шагов, отметка посещённых или заранее известная длина.
- Обнаружение цикла: алгоритм Флойда («черепаха и заяц») — время O(n), память O(1); позволяет также найти вход в цикл.
- Операции вставки/удаления аналогичны обычным спискам, но важно корректно перенастраивать ссылки, чтобы сохранить целостность кольца.
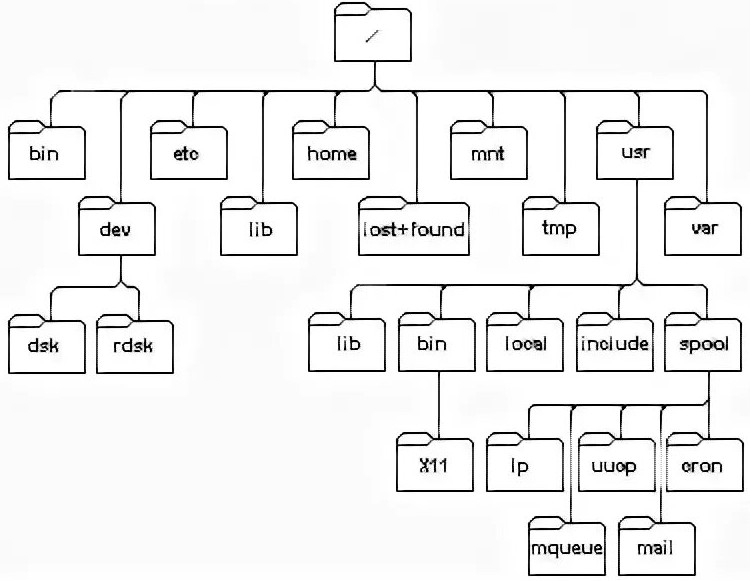
Дерево — иерархическая (ацикличная) структура «родитель → дети». Ключевые термины: корень, узел, лист, поддерево, глубина (от корня до узла), высота (макс. глубина дерева). Бинарное дерево — у каждого узла не более двух детей (left/right). Бинарное дерево поиска (BST) удовлетворяет свойству: все значения слева < узла < все значения справа.
- N-арное дерево: словарь смежности adj = {node: [children...]},
root— корень. Пример (одной строкой), чтобы видеть формат:
adj = {"A": ["B", "C"], "B": ["D"], "C": [], "D": []};
root = "A"- Бинарное дерево: удобно хранить как кортежи
(value, left, right), гдеleft/right—Noneили кортеж; это позволяет, например, описывать BST и применять in‑order обход. - В реальности деревья часто реализуются через отдельный класс узла, ссылающегося на потомков. Но об этом в следующих лекциях.
-
Порядки обхода (для деревьев):
- Pre-order (узел → левое поддерево → правое поддерево): родитель посещается раньше детей; полезно для
сериализации/копирования и задач, где важно обрабатывать узел до его потомков.
- In-order (левое → узел → правое): определён для бинарных деревьев; для BST даёт значения в отсортированном
порядке.
- Post-order (левое → правое → узел): родитель посещается после детей; полезно, когда результат узла зависит от
результатов поддеревьев (удаление/подсчёты/вычисление выражений).
- Pre-order (узел → левое поддерево → правое поддерево): родитель посещается раньше детей; полезно для
сериализации/копирования и задач, где важно обрабатывать узел до его потомков.
-
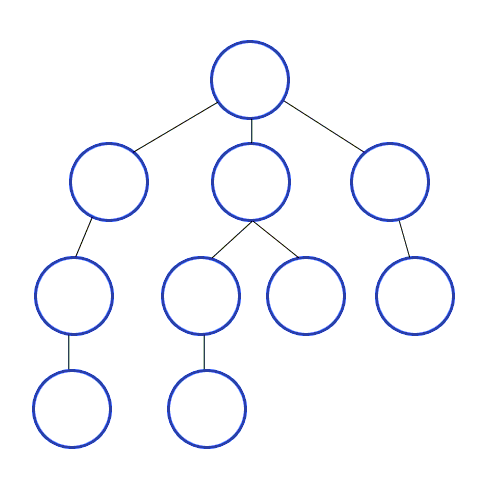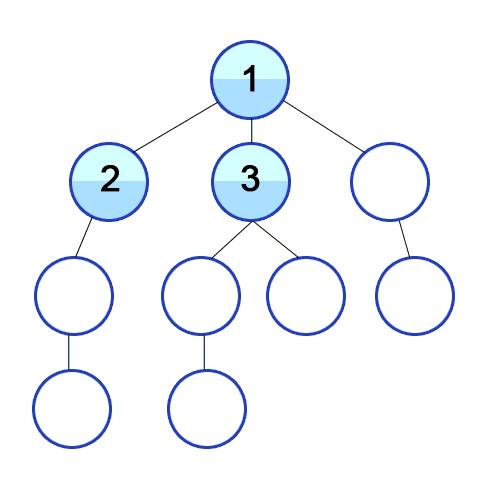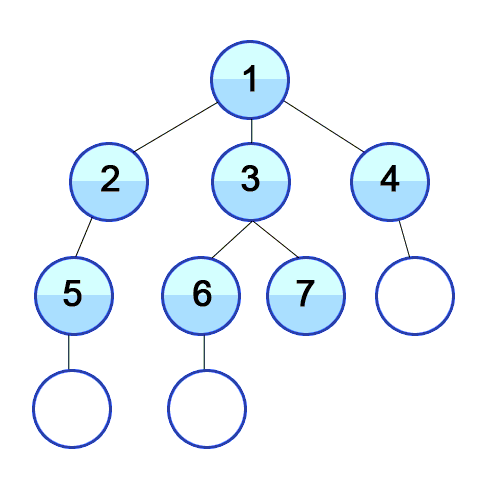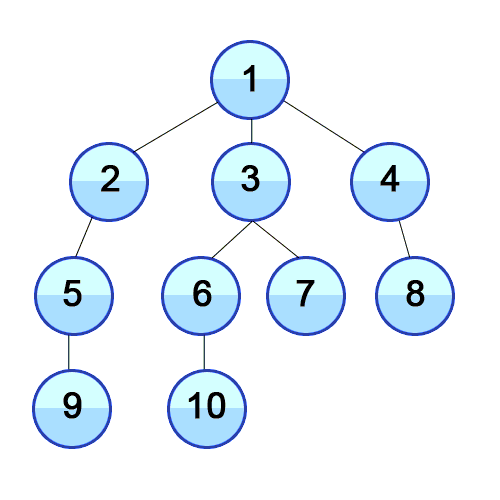
DFS (поиск в глубину):
- Идея: идти «вниз» до упора, откатываться назад, затем идти в следующую ветвь.
- Реализация: рекурсивно или через явный стек. В деревьях множества посещённых не требуется (нет циклов); в графах — необходимо.
- Сложность: время O(n) по числу узлов; память O(h), где h — высота (в худшем случае O(n)). Возможен RecursionError при большой глубине.
- Когда применять: проверки свойств дерева, вычисление агрегатов (высота, размер, сумма), поиск пути до определённого условия, топологические задачи на DAG.


- BFS (поиск в ширину):
- Идея: проход по «уровням» от корня, используя очередь. Порядок посещения — level‑order.
- Свойства: полнота (на конечных графах/деревьях найдёт решение, если оно есть); оптимальность по числу рёбер в невзвешенном графе (находит кратчайший путь по количеству шагов).
- Сложность: время O(n); память O(w), где w — максимальная ширина уровня (в худшем случае может быть O(n)).
- Когда применять: поиск кратчайшего пути (по числу шагов), задачи «на расстояние/слои», вычисление высоты через уровни, задачи на очереди/волновой обход.
- Сравнение DFS vs BFS:
- Память: DFS обычно экономичнее (O(h) против O(w)).
- Кратчайшие пути: BFS предпочтителен в невзвешенных графах/деревьях.
- Раннее обнаружение: DFS быстрее «ныряет» к глубоким решениям; BFS раньше увидит «близкие» решения.

- Свойство: для каждого узла все ключи слева меньше, справа — больше. In-order обход выдаёт значения в отсортированном порядке.
- Поиск/вставка: в среднем O(log n) при «разумной» сбалансированности; в худшем O(n), если дерево выродилось в цепочку ( например, при вставке уже отсортированных данных).
- Построение почти сбалансированного BST: из отсортированного списка — брать середину как корень, рекурсивно строить левое/правое поддеревья из левой/правой половин.
- Высота дерева: максимальная длина пути от корня до листа. Можно посчитать DFS (post-order: max(высота_лево, высота_право)+1) или BFS по уровням. В обоих случаях время O(n).
Несбалансированное BST может выродиться в «список» — тогда операции поиска/вставки становятся O(n). Балансируемые деревья (например, AVL, красно‑чёрные) поддерживают высоту O(log n), поэтому поиск/вставка/удаление работают за O(log n) и в худшем случае. В этой лекции — обзорно, без реализации.
- Файловые системы и иерархии (директории/поддиректории): обход каталогов (DFS/BFS), построение путей (breadcrumbs), подсчёт суммарного размера папки (post-order), массовые операции над поддеревьями (перенос/удаление).
- DOM/AST: разбор кода/разметки в дерево, поиск/замена узлов, трансформации (линеры/форматтеры), оптимизации. Обход pre/post-order задаёт порядок применения правил; в AST вычисление выражений обычно идёт post-order.
- Навигация/меню/оргструктуры: построение иерархических меню, фильтрация/скрытие ветвей, расчёт «глубины» для визуализации, наследование настроек сверху вниз.
- Поиск и индексация: BST как базовая идея упорядоченного поиска и диапазонных запросов (in-order даёт отсортированный вывод). На практике используют B/B+-деревья, Trie/Prefix-деревья (для автодополнения) — концептуально те же обходы.
- Графика/игры/ИИ: деревья принятия решений/поведения, иерархии сцен, пространственные деревья (Quad/Oct) для ускорения поиска столкновений — обходами быстро сузить область.
- Машинное обучение: деревья решений, ансамбли (Random Forest/Gradient Boosting) строят дерево разбиений признаков; обходы используются для предсказания и экспорта моделей.
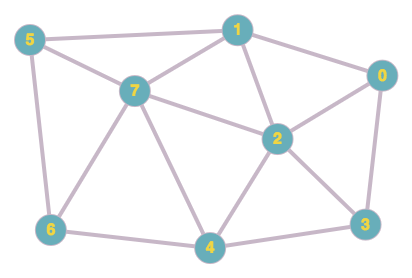
По сути, если разрешить цикличность в деревьях, то получим граф. Граф — это дерево, у которого каждый элемент может иметь несколько родителей.
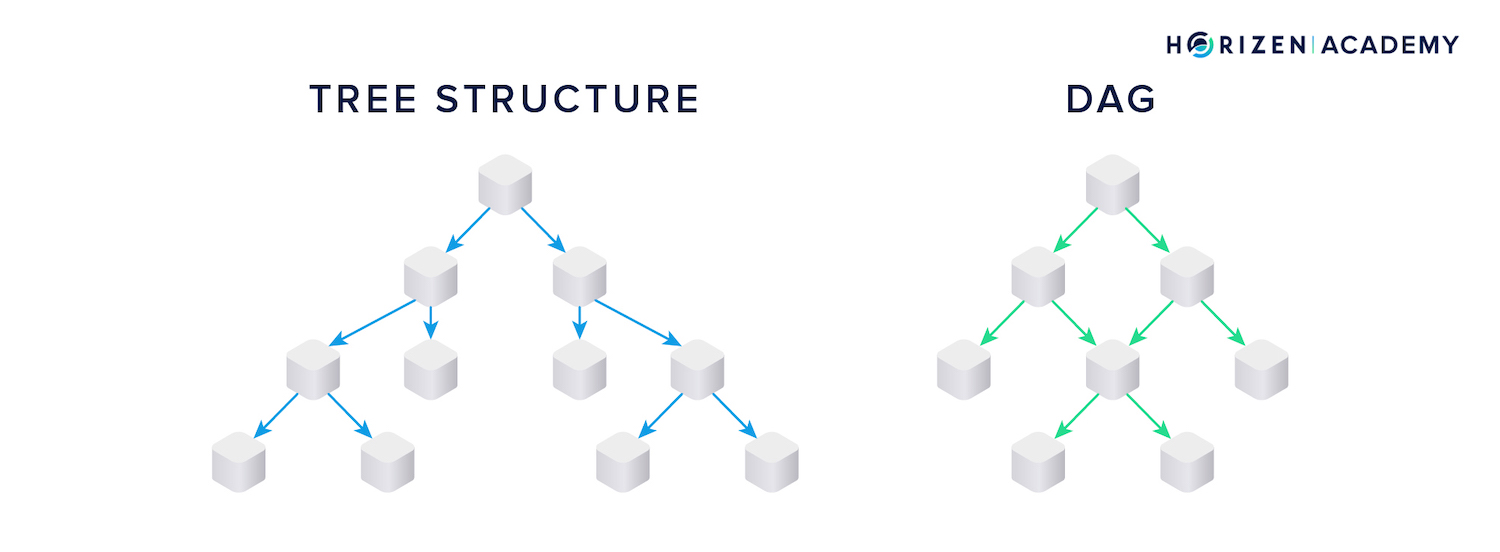
Эта структура данных нам тоже много где пригодится. Но в первую очередь нас будет интересовать DAG (Directed Acyclic Graph) — направленный ациклический граф. Потому что на нём работает Git, о чём мы и поговорим на следующем занятии.
Огромным пластом алгоритмов являются алгоритмы сортировки. Давайте посмотрим на некоторые из них.
Пузырьковая сортировка — это простой алгоритм сортировки, который многократно проходит по списку, сравнивает соседние элементы и меняет их местами, если они находятся в неправильном порядке. Этот процесс повторяется до тех пор, пока список не будет отсортирован.

- Сравнивайте каждый элемент списка с его соседним.
- Меняйте их местами, если они в неправильном порядке.
- Повторяйте процесс до тех пор, пока не будет произведен проход по списку без единой перестановки.
def bubble_sort(arr: list[int]) -> list[int]:
    n = len(arr)
    for i in range(n):
        swapped = False
        for j in range(0, n - i - 1):
            if arr[j] > arr[j + 1]:
                arr[j], arr[j + 1] = arr[j + 1], arr[j]
                swapped = True
        if not swapped:
            break
    return arr


# Пример использования
arr = [64, 34, 25, 12, 22, 11, 90]
print(f"Отсортированный массив: {bubble_sort(arr)}")
Сортировка слиянием — это эффективный алгоритм сортировки, который использует принцип «разделяй и властвуй». Он рекурсивно делит массив пополам, сортирует каждую половину и затем объединяет их.
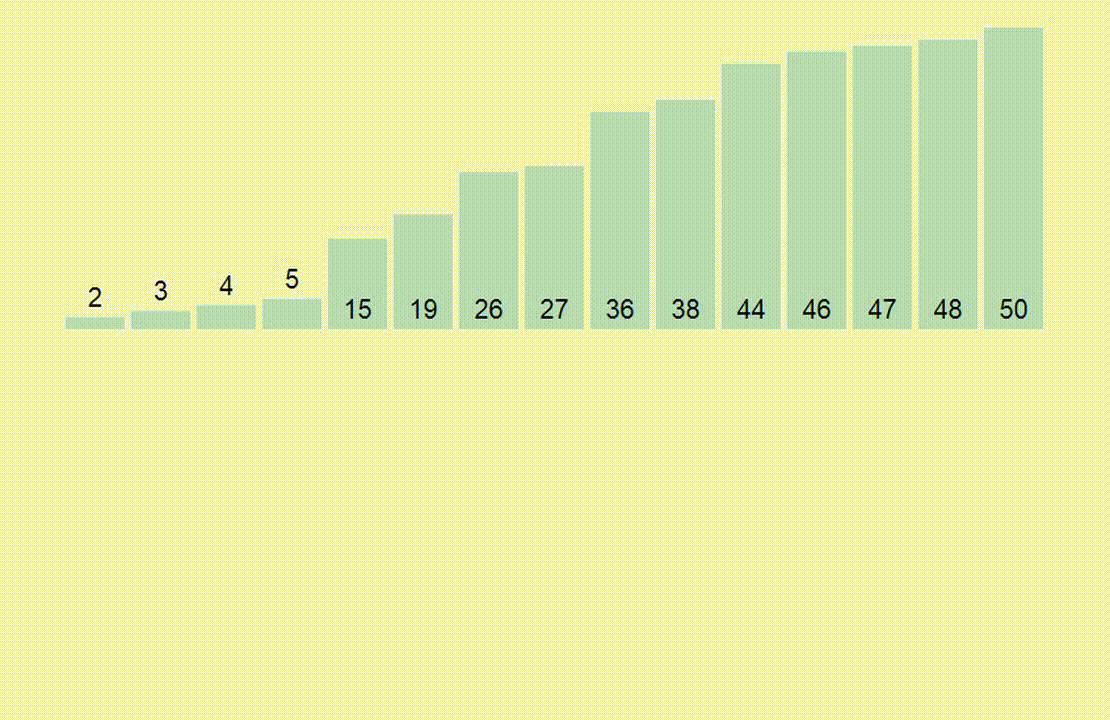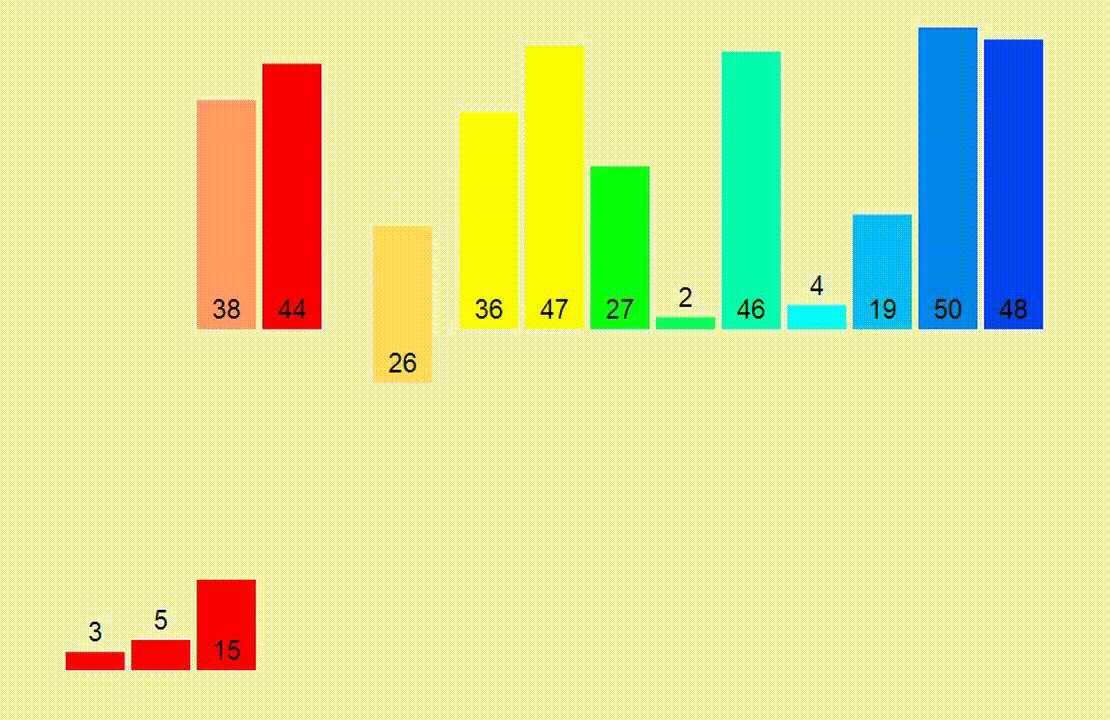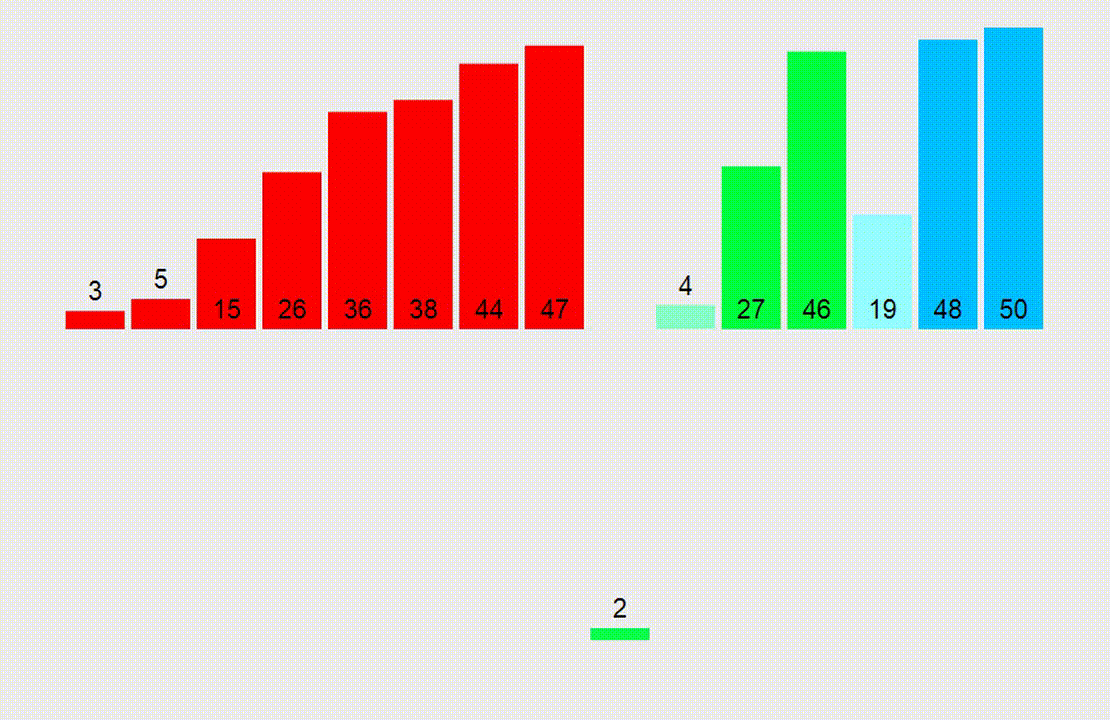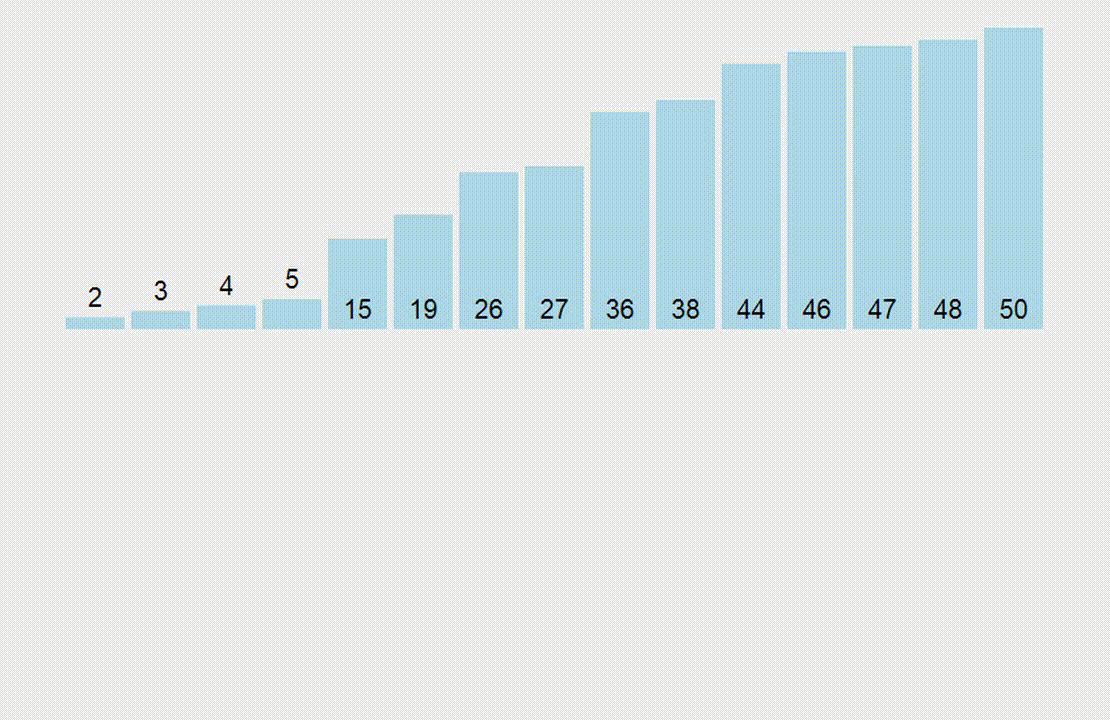
- Разделите массив на две половины.
- Рекурсивно отсортируйте каждую половину.
- Объедините две отсортированные половины в один отсортированный массив.
def merge_sort(arr: list[int]) -> list[int]:
    if len(arr) <= 1:
        return arr

    mid = len(arr) // 2
    left_half = merge_sort(arr[:mid])
    right_half = merge_sort(arr[mid:])

    return merge(left_half, right_half)


def merge(left: list[int], right: list[int]) -> list[int]:
    result = []
    i = j = 0

    while i < len(left) and j < len(right):
        if left[i] < right[j]:
            result.append(left[i])
            i += 1
        else:
            result.append(right[j])
            j += 1

    result.extend(left[i:])
    result.extend(right[j:])
    return result


# Пример использования
arr = [38, 27, 43, 3, 9, 82, 10]
print(f"Отсортированный массив: {merge_sort(arr)}")
Быстрая сортировка — это ещё один эффективный алгоритм сортировки, который использует принцип «разделяй и властвуй». Он выбирает опорный элемент (пивот) и разделяет массив на две части: элементы, меньшие пивота, и элементы, большие пивота. Затем рекурсивно сортирует каждую часть.
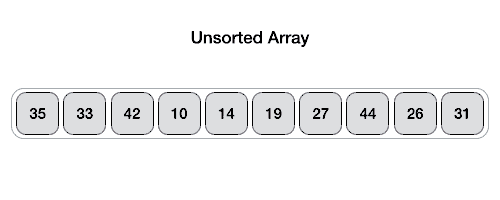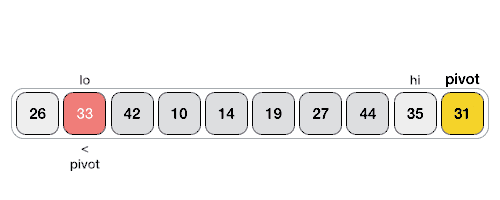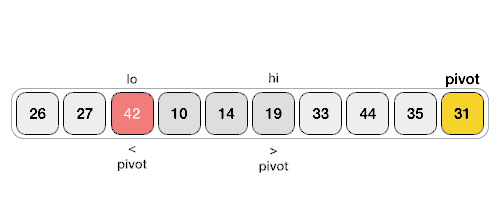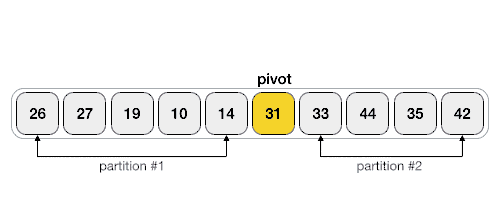
- Выберите опорный элемент (пивот).
- Переставьте элементы массива так, чтобы элементы, меньшие пивота, были слева от него, а элементы, большие пивота, были справа.
- Рекурсивно примените те же шаги к подмассивам слева и справа от пивота.
def quick_sort(arr: list[int]) -> list[int]:
    if len(arr) <= 1:
        return arr

    pivot = arr[len(arr) // 2]
    left = [x for x in arr if x < pivot]
    middle = [x for x in arr if x == pivot]
    right = [x for x in arr if x > pivot]

    return quick_sort(left) + middle + quick_sort(right)


# Пример использования
arr = [3, 6, 8, 10, 1, 2, 1]
print(f"Отсортированный массив: {quick_sort(arr)}")Встроенные функции sorted() и метод list.sort() используют алгоритм Timsort — стабильную сортировку со средней
сложностью O(n log n), очень эффективную на «почти отсортированных» данных.
sorted(iterable, key=..., reverse=...)— возвращает новый списокlist.sort(key=..., reverse=...)— сортирует список на месте (in-place), возвращаетNone
students = [
    {"name": "Alice", "age": 20, "grade": 5},
    {"name": "Bob", "age": 22, "grade": 5},
    {"name": "Eve", "age": 19, "grade": 4},
]
# Стабильная сортировка по нескольким ключам: сначала по grade (возр.), затем по age (убыв.)
students.sort(key=lambda s: (s["grade"], -s["age"]))
# Или: sorted(students, key=..., reverse=...) — когда нужен новый список
Примечание: «стабильная» означает, что относительный порядок равных по ключу элементов сохраняется.
Python использует в качестве базового алгоритма сортировки Timsort, который является гибридным алгоритмом, сочетающим в себе сортировку слиянием и вставками. Timsort был разработан Тимом Петерсом и впервые использовался в Python 2.3. Детали реализации нам не очень важны, но в реальности он работает немного быстрее, чем алгоритмы, которые мы обсудили.

Изучение алгоритмов и их эффективная реализация является ключевой частью программирования. Понимание различных алгоритмов сортировки и поиска, таких как бинарный поиск, пузырьковая сортировка, сортировка слиянием и быстрая сортировка, поможет вам писать более эффективный и оптимизированный код. Экспериментируйте с этими алгоритмами, чтобы лучше понять их работу и области применения.
Знать эту тему важно, чтобы понимать, является ли ваш код эффективным, уметь оценить сложность собственного кода и не придумывать велосипед, когда ваша задача попадает под стандартные алгоритмы.
Рекомендую хотя бы поверхностно ознакомиться с алгоритмами поиска пути, динамического программирования, подходом «двойных указателей» и т. д.
Нельзя закончить изучать алгоритмы — можно только перестать.
На этом мы заканчиваем изучение базовых знаний по Python.
- Реализуйте бинарный поиск (итеративно). Продумайте поведение при дубликатах: какой индекс возвращать?
- Перепишите бинарный поиск рекурсивно и сравните читаемость и сложность.
- Используя
bisect_left, вставьте элемент в отсортированный список, сохраняя порядок. - Реализуйте функцию
fib(n)итеративно. Оцените сложность и сравните время для n=30–40 с наивной рекурсией. - Реализуйте
merge_sortи кратко опишите временную и пространственную сложность. - Отсортируйте список словарей студентов по (grade возр., age убыв.) с помощью
key=lambda s: (s['grade'], -s['age']). - Мини‑вопросы по Big‑O: укажите порядок роста для: a) двойного вложенного цикла; b) бинарного поиска; c) сортировки слиянием.
- По словарю смежности постройте дерево и выведите порядок обхода DFS (pre-order) и BFS.
- Реализуйте функции
height(adj, root)иcount_leaves(adj, root)— верните высоту и число листьев. - Для бинарного дерева в виде кортежей реализуйте
inorderиpostorder; сравните порядок с pre-order. - Проверьте, является ли заданная структура кортежей BST (
is_bst). Реализуйте поискbst_search(t, x).
Для практики по всему блоку ссылка
Переходим к первому модульному заданию
← Лекция 5: Функции, типизация, lambda. Map, zip, filter. | Лекция 7: Git. История системы контроля версий. Локальный репозиторий. Базовые команды управления репозиторием. →